Ferramenta grátis
Imagem para texto (OCR)
Copie o texto de uma foto, print ou página escaneada. Tudo roda no seu navegador, então a sua imagem nunca é enviada.
Testado por Thiago · Atualizado em
Grátis, sem cadastro · Roda no seu navegador: seus arquivos nunca são enviados
Solte uma imagem aqui
ou
Como copiar o texto de uma imagem
- Adicione uma foto, um print ou uma página escaneada, ou cole um print com Ctrl+V.
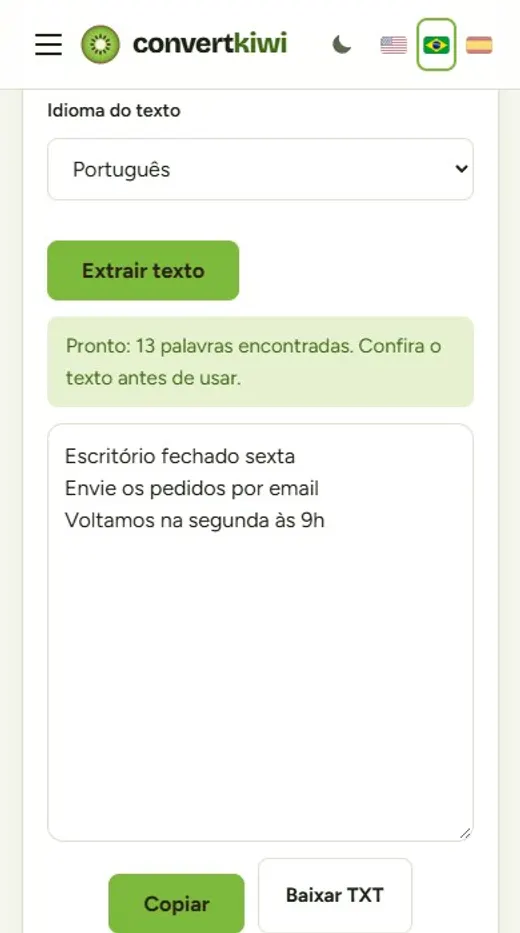
- Escolha o idioma do texto e clique em "Extrair texto". Na primeira vez o leitor é baixado, então leva alguns segundos a mais.
- Confira o texto, corrija o que o leitor tiver errado e depois copie ou baixe como arquivo TXT.
Para que as pessoas usam
- Copiar um parágrafo de um print em vez de digitar tudo de novo.
- Tirar o texto de uma foto de documento, carta ou mural de avisos.
- Transformar uma página escaneada em texto editável para um relatório ou e-mail.
- Pegar um endereço, um telefone ou um número de série de uma imagem.
Como o OCR lê a sua imagem
O OCR (reconhecimento óptico de caracteres) encontra as linhas de texto na imagem, separa as palavras e reconhece cada uma com um modelo treinado em muito texto impresso. O leitor usado aqui é o Tesseract, um projeto de código aberto. Ele roda como WebAssembly, a tecnologia que permite programas complexos funcionarem dentro do navegador, e por isso não precisa enviar nada.
Como ele lê letras impressas, o resultado depende principalmente da imagem: texto nítido, reto e bem iluminado sai quase perfeito, enquanto texto borrado, torto ou com pouco contraste gera erros. O leitor também usa um dicionário do idioma escolhido, o que ajuda a decidir entre letras parecidas.
Dicas para o melhor resultado
- Fotografe a página de frente, ocupando a tela toda, com boa luz e sem sombra em cima do texto.
- Corte tudo o que não for texto: bordas, fotos e enfeites podem confundir o leitor.
- Letras muito pequenas saem melhor de uma imagem maior e mais nítida. Um print em zoom normal costuma ser perfeito.
- Texto escuro em fundo claro funciona melhor. Texto claro em fundo escuro é lido com menos precisão.
- Sempre leia o resultado antes de usar: números, nomes e palavras em outro idioma são onde os erros costumam aparecer.
Guias úteis
Perguntas frequentes
A imagem é enviada para algum servidor?
Não. O reconhecimento de texto roda dentro do seu navegador com o Tesseract, um leitor de OCR de código aberto. A sua imagem nunca sai do seu aparelho e nada é guardado.
Quais idiomas ele lê?
Português, inglês e espanhol. Escolha o idioma do texto antes de começar: o leitor usa um dicionário daquele idioma, então escolher o certo dá resultados bem melhores.
Ele lê letra de mão?
Mal. O leitor foi treinado com texto impresso. Letra de forma bem caprichada às vezes funciona, mas letra cursiva costuma sair errada.
Por que a primeira vez é mais lenta?
Na primeira vez, o navegador baixa o leitor (cerca de 4 MB) e o arquivo do idioma (1,4 a 3 MB). Depois eles ficam guardados no navegador, então as próximas imagens começam bem mais rápido.
Funciona no celular?
Sim, em qualquer navegador atual. Ler uma foto grande usa o processador do celular, então pode demorar um pouco mais do que no computador.
Dá para tirar o texto de um PDF?
Não direto. Se o PDF for escaneado, primeiro salve as páginas como imagem com o PDF para JPG e depois leia cada página aqui. Se você consegue selecionar o texto no leitor de PDF, o PDF já tem o texto e é só copiar.