Herramienta gratis
Imagen a texto (OCR)
Copia el texto de una foto, captura de pantalla o página escaneada. Todo funciona en tu navegador, así que tu imagen nunca se sube.
Probado por Thiago · Actualizado el
Gratis, sin registro · Funciona en tu navegador: tus archivos nunca se suben
Suelta una imagen aquí
o
Cómo copiar el texto de una imagen
- Agrega una foto, una captura de pantalla o una página escaneada, o pega una captura con Ctrl+V.
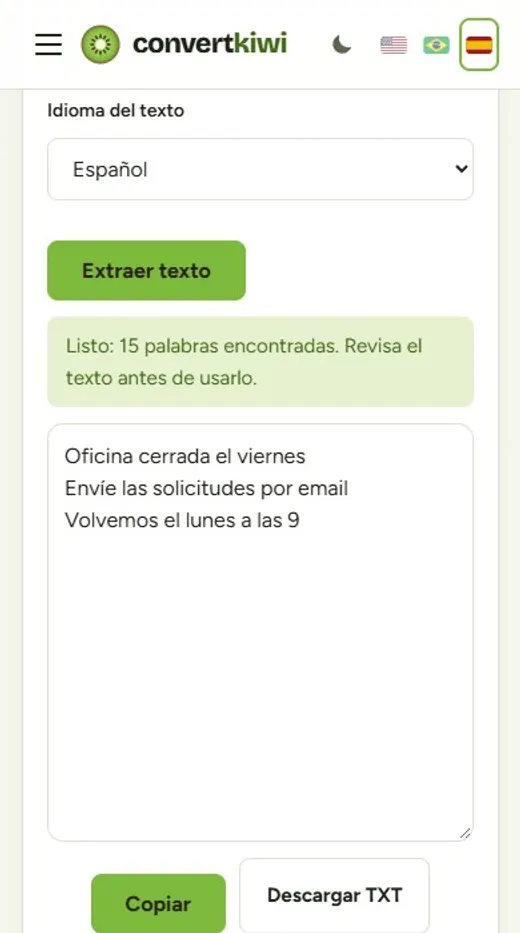
- Elige el idioma del texto y haz clic en "Extraer texto". La primera vez se descarga el lector, así que tarda unos segundos más.
- Revisa el texto, corrige lo que el lector haya leído mal y luego cópialo o descárgalo como archivo TXT.
Para qué lo usa la gente
- Copiar un párrafo de una captura de pantalla en lugar de escribirlo otra vez.
- Sacar el texto de una foto de un documento, una carta o un tablón de anuncios.
- Convertir una página escaneada en texto editable para un informe o un correo.
- Tomar una dirección, un teléfono o un número de serie de una imagen.
Cómo lee el OCR tu imagen
El OCR (reconocimiento óptico de caracteres) encuentra las líneas de texto en la imagen, separa las palabras y reconoce cada una con un modelo entrenado con mucho texto impreso. El lector que se usa aquí es Tesseract, un proyecto de código abierto. Funciona como WebAssembly, la tecnología que permite ejecutar programas complejos dentro del navegador, y por eso no hace falta subir nada.
Como lee letras impresas, el resultado depende sobre todo de la imagen: un texto nítido, derecho y bien iluminado sale casi perfecto, mientras que un texto borroso, torcido o con poco contraste produce errores. El lector también usa un diccionario del idioma que elijas, lo que lo ayuda a decidir entre letras parecidas.
Consejos para el mejor resultado
- Fotografía la página de frente, llenando la pantalla, con buena luz y sin sombras sobre el texto.
- Recorta todo lo que no sea texto: bordes, fotos y adornos pueden confundir al lector.
- Las letras muy pequeñas se leen mejor desde una imagen más grande y nítida. Una captura con zoom normal suele ser perfecta.
- El texto oscuro sobre fondo claro funciona mejor. El texto claro sobre fondo oscuro se lee con menos precisión.
- Lee siempre el resultado antes de usarlo: los números, los nombres y las palabras en otro idioma son donde suelen esconderse los errores.
Guías útiles
Preguntas frecuentes
¿La imagen se sube a algún servidor?
No. El reconocimiento de texto funciona dentro de tu navegador con Tesseract, un lector de OCR de código abierto. Tu imagen nunca sale de tu dispositivo y no se guarda nada.
¿Qué idiomas puede leer?
Español, inglés y portugués. Elige el idioma del texto antes de empezar: el lector usa un diccionario de ese idioma, así que elegir el correcto da resultados bastante mejores.
¿Puede leer letra a mano?
Mal. El lector está entrenado con texto impreso. La letra de imprenta muy cuidada a veces funciona, pero la letra cursiva suele salir mal.
¿Por qué la primera vez es más lenta?
La primera vez, el navegador descarga el lector (unos 4 MB) y el archivo del idioma (de 1,4 a 3 MB). Después quedan guardados en el navegador, así que las siguientes imágenes empiezan mucho más rápido.
¿Funciona en el celular?
Sí, en cualquier navegador actual. Leer una foto grande usa el procesador del celular, así que puede tardar un poco más que en una computadora.
¿Puedo sacar el texto de un PDF?
No directamente. Si el PDF es escaneado, primero guarda sus páginas como imágenes con PDF a JPG y luego lee cada página aquí. Si puedes seleccionar el texto en tu lector de PDF, el PDF ya contiene el texto y basta con copiarlo.